RAG 内部智能助手
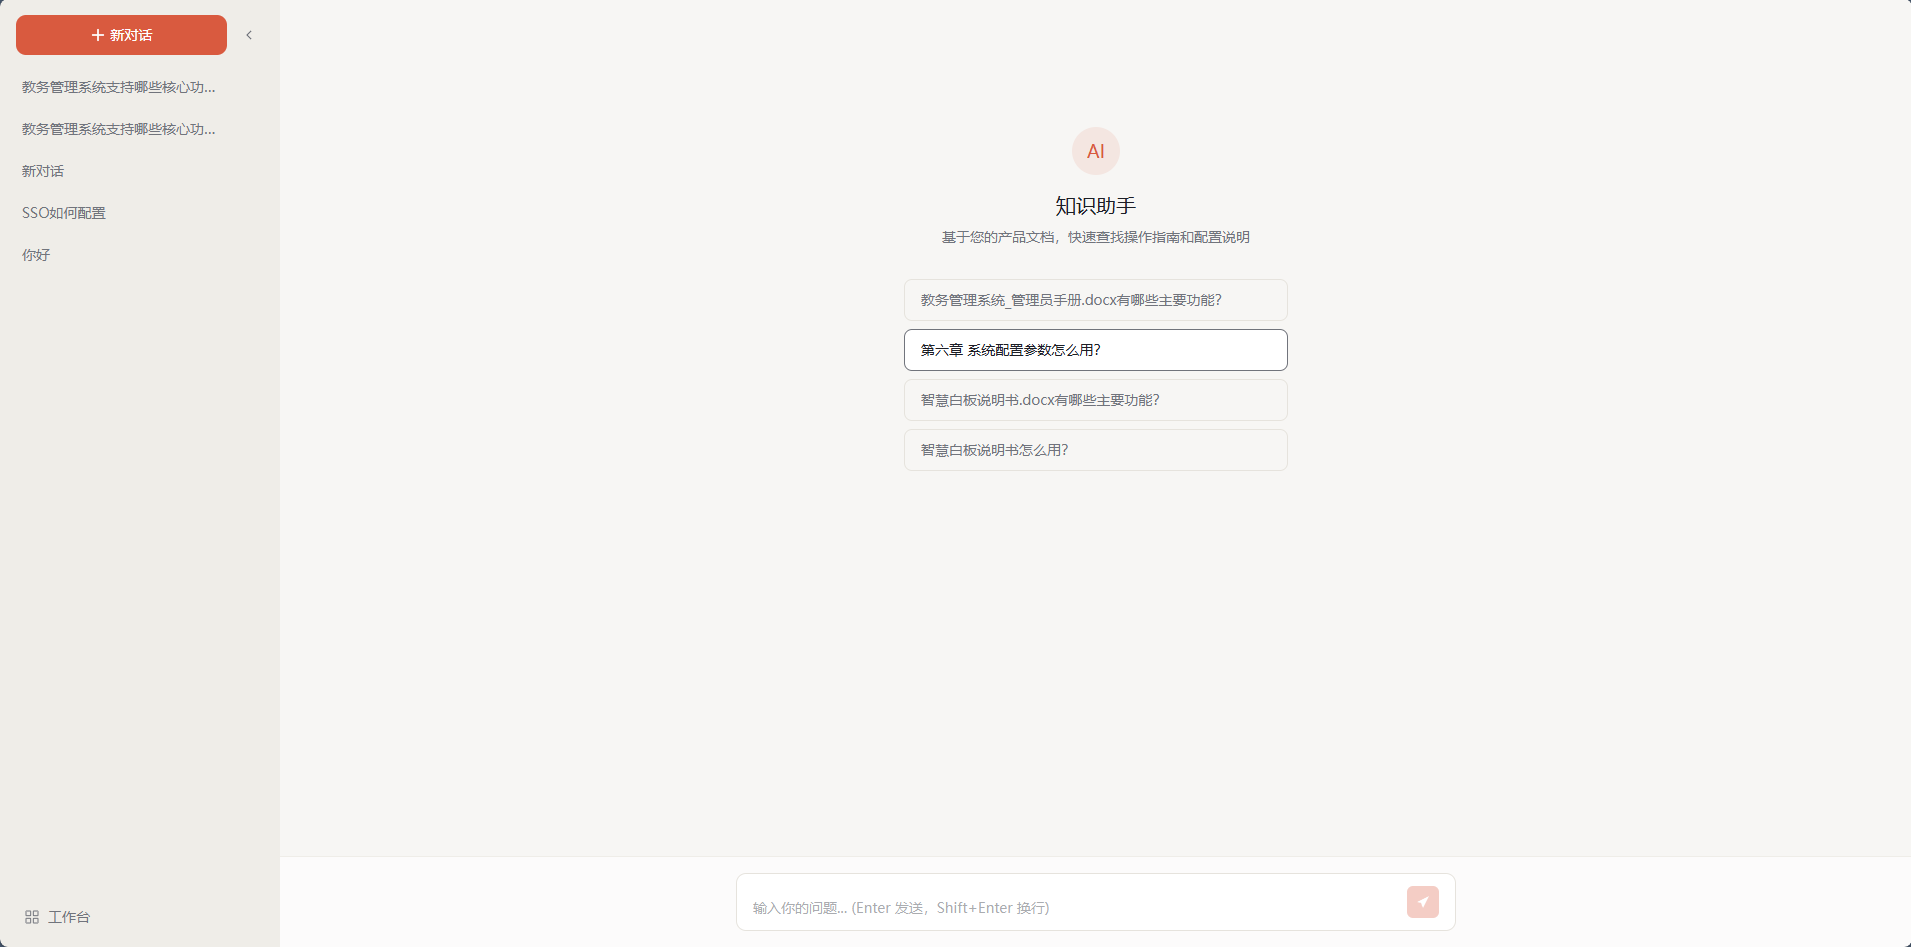
面向企业内部员工的 AI 知识检索助手。覆盖文档摄入、智能问答、引用溯源、对话历史四大模块,MVP 已上线。
AI产品经理
已上线
DeepSeek API · BGE (bge-small-zh-v1.5) · ChromaDB · FastAPI · Next.js 14 · Tailwind CSS · SQLite · python-docx · fastembed
设计动机§
公司产品文档(教务管理系统手册、运维 SOP、培训资料)散落在 Confluence、本地 Word、PDF 附件里。新人入职问"管理员密码忘了怎么重置"这种问题,要么翻半小时文档,要么直接 @老员工——知识在团队里,但不在员工脑子里。
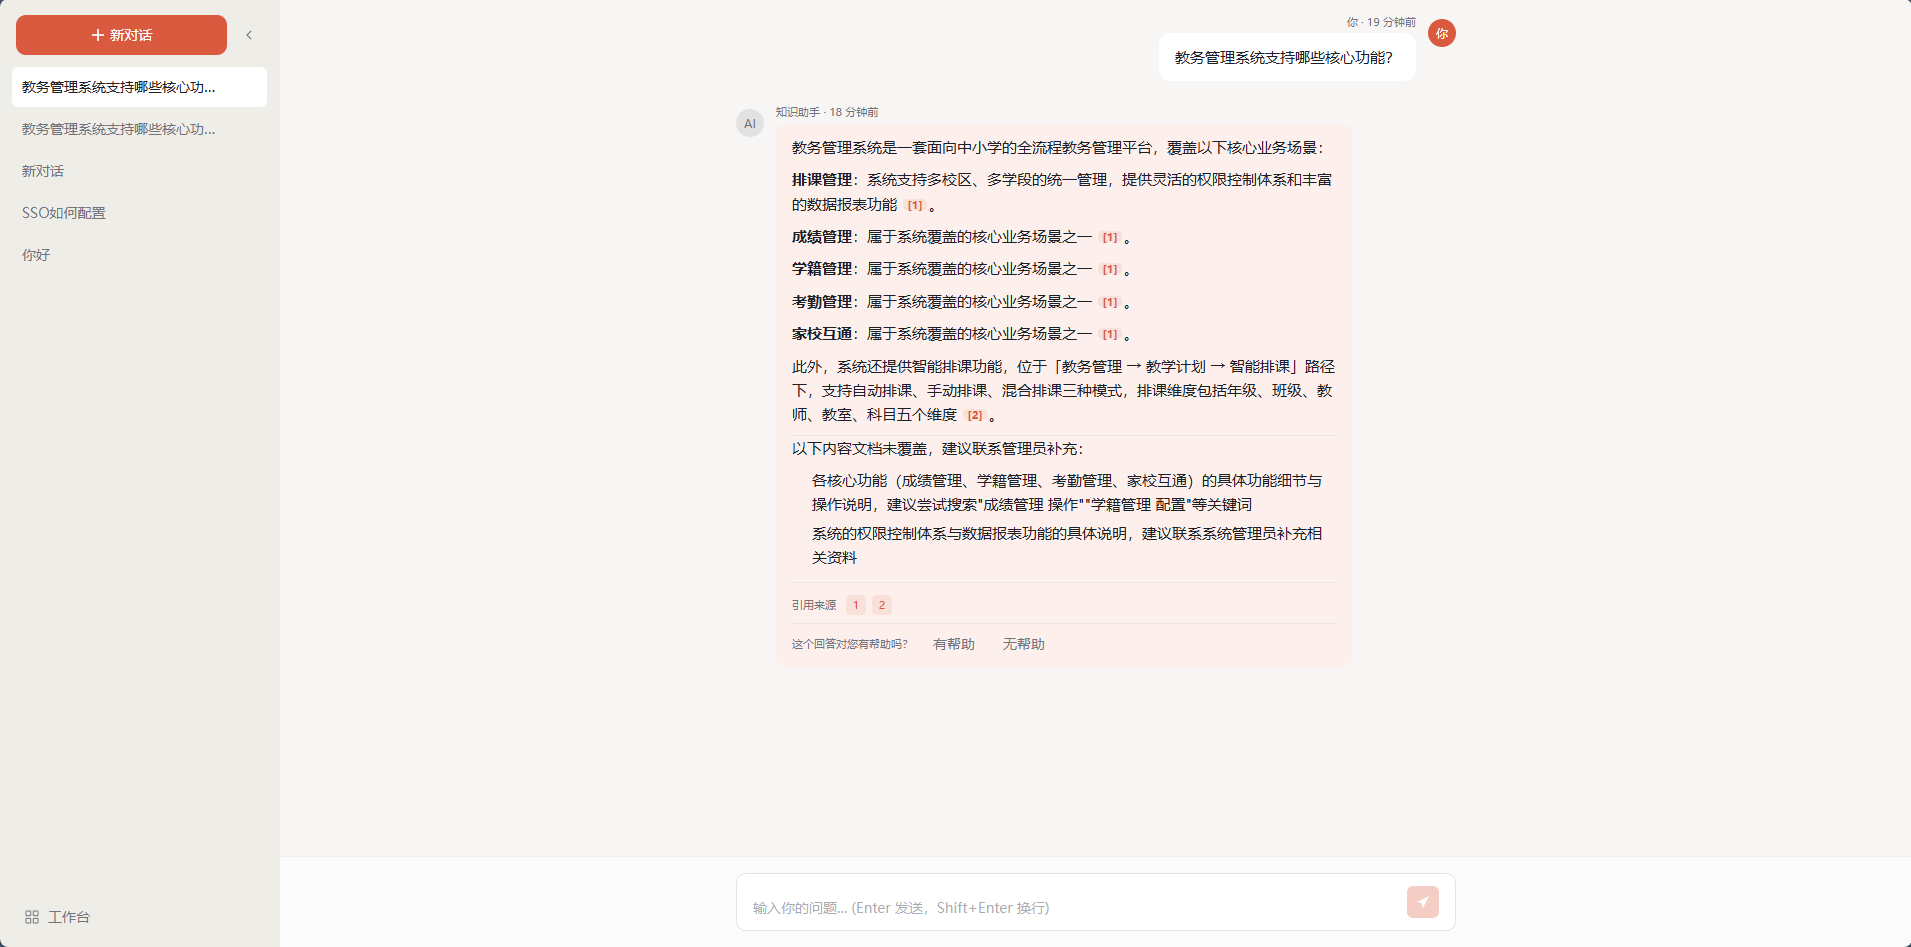
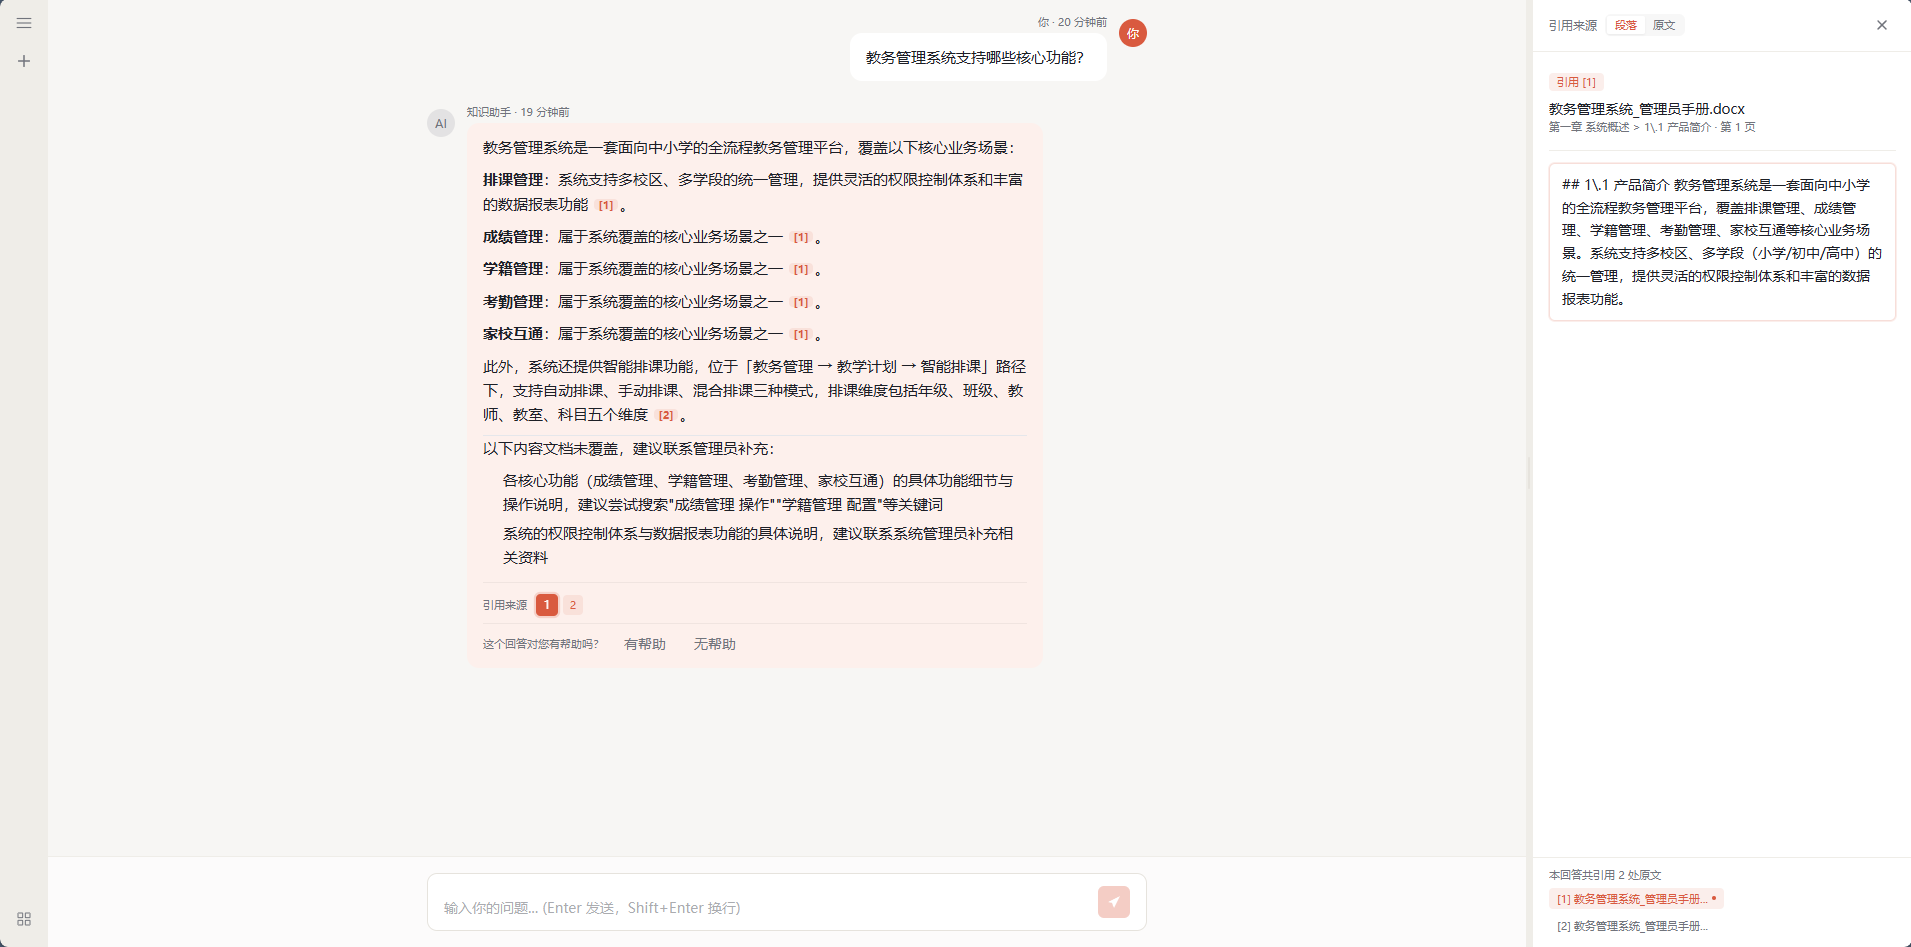
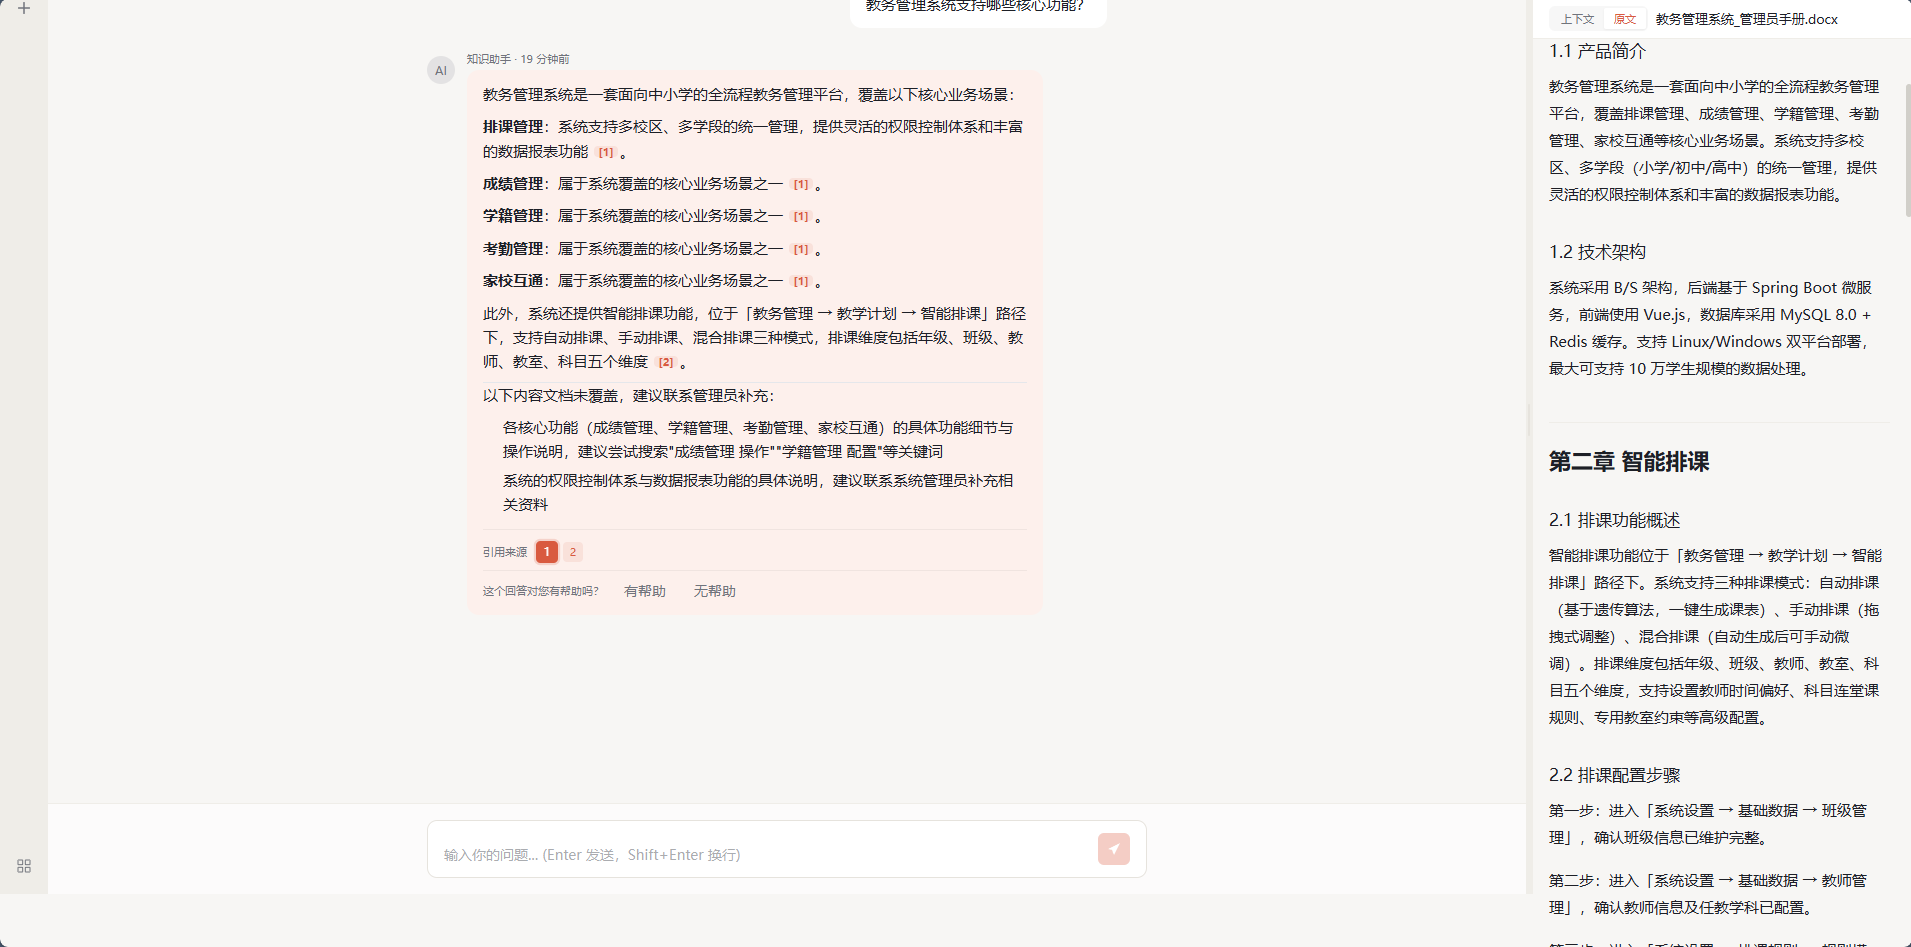
RAG 内部智能助手 把这套流程压缩成一次自然语言提问:上传文档 → 自动向量化 → 像问同事一样问 → 拿到带原文出处的答案。引用标记 [1][2] 直接点回原文位置,可信、可追溯、可审计。
核心特性§
文档智能摄入§
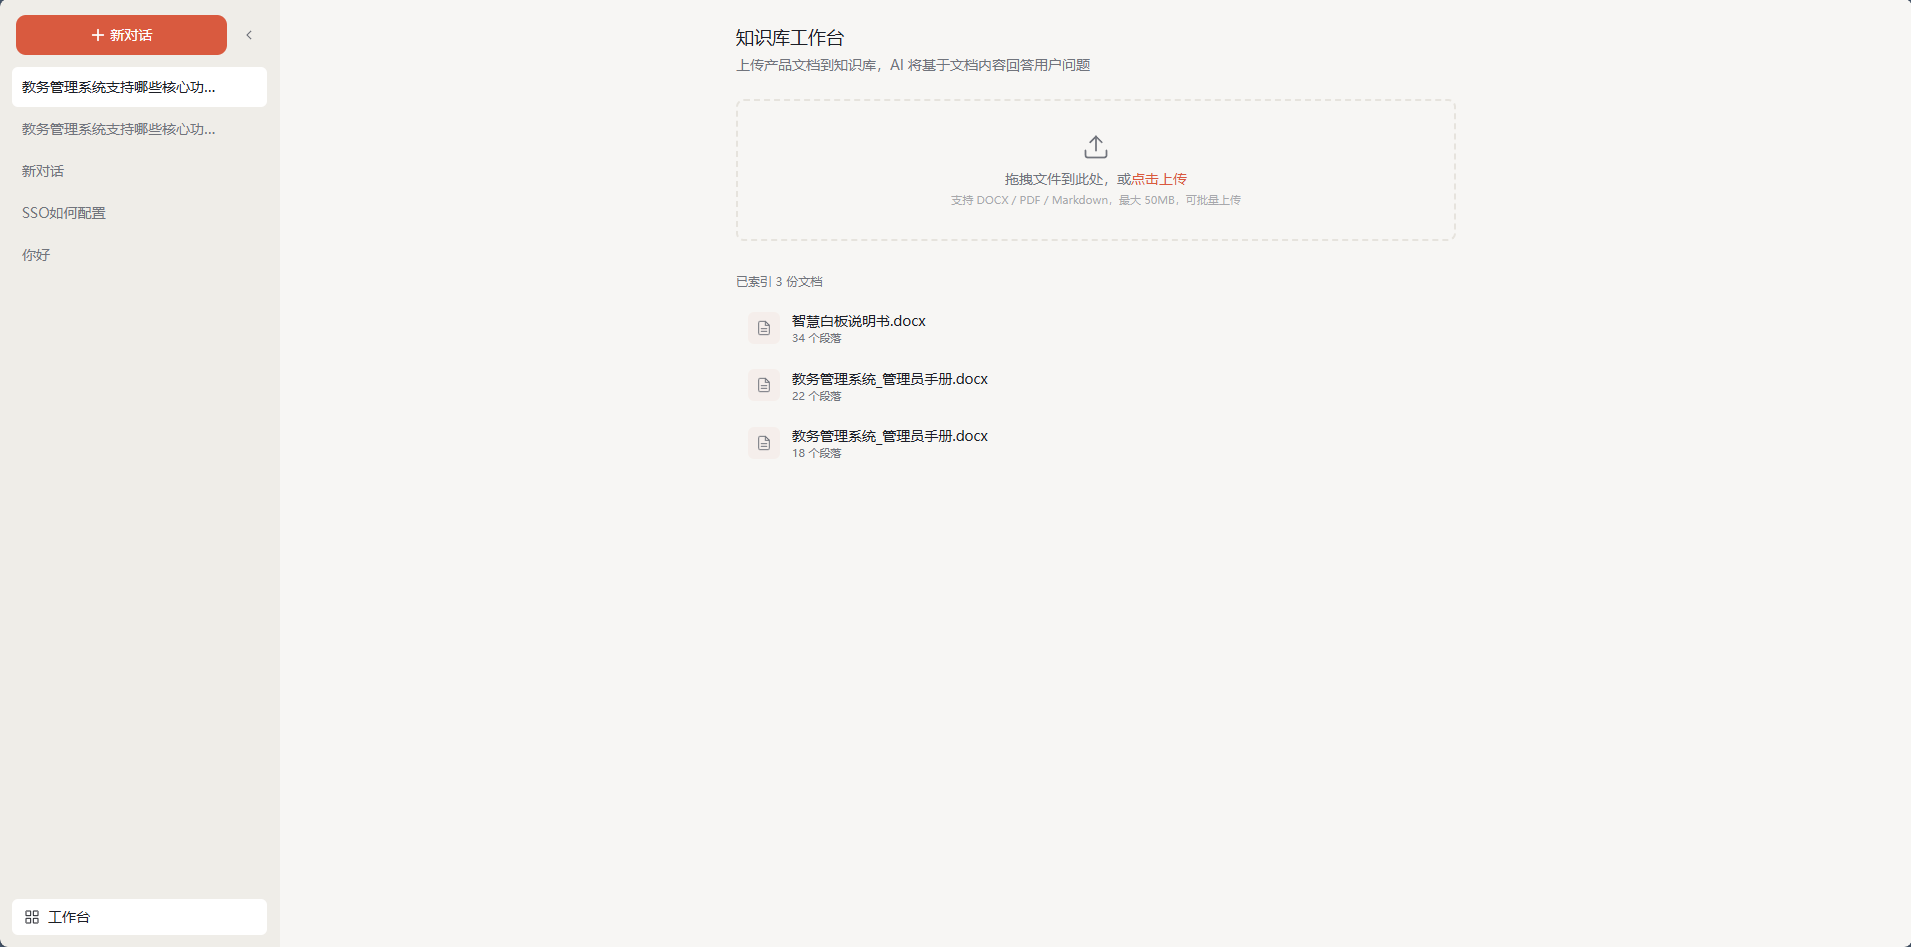
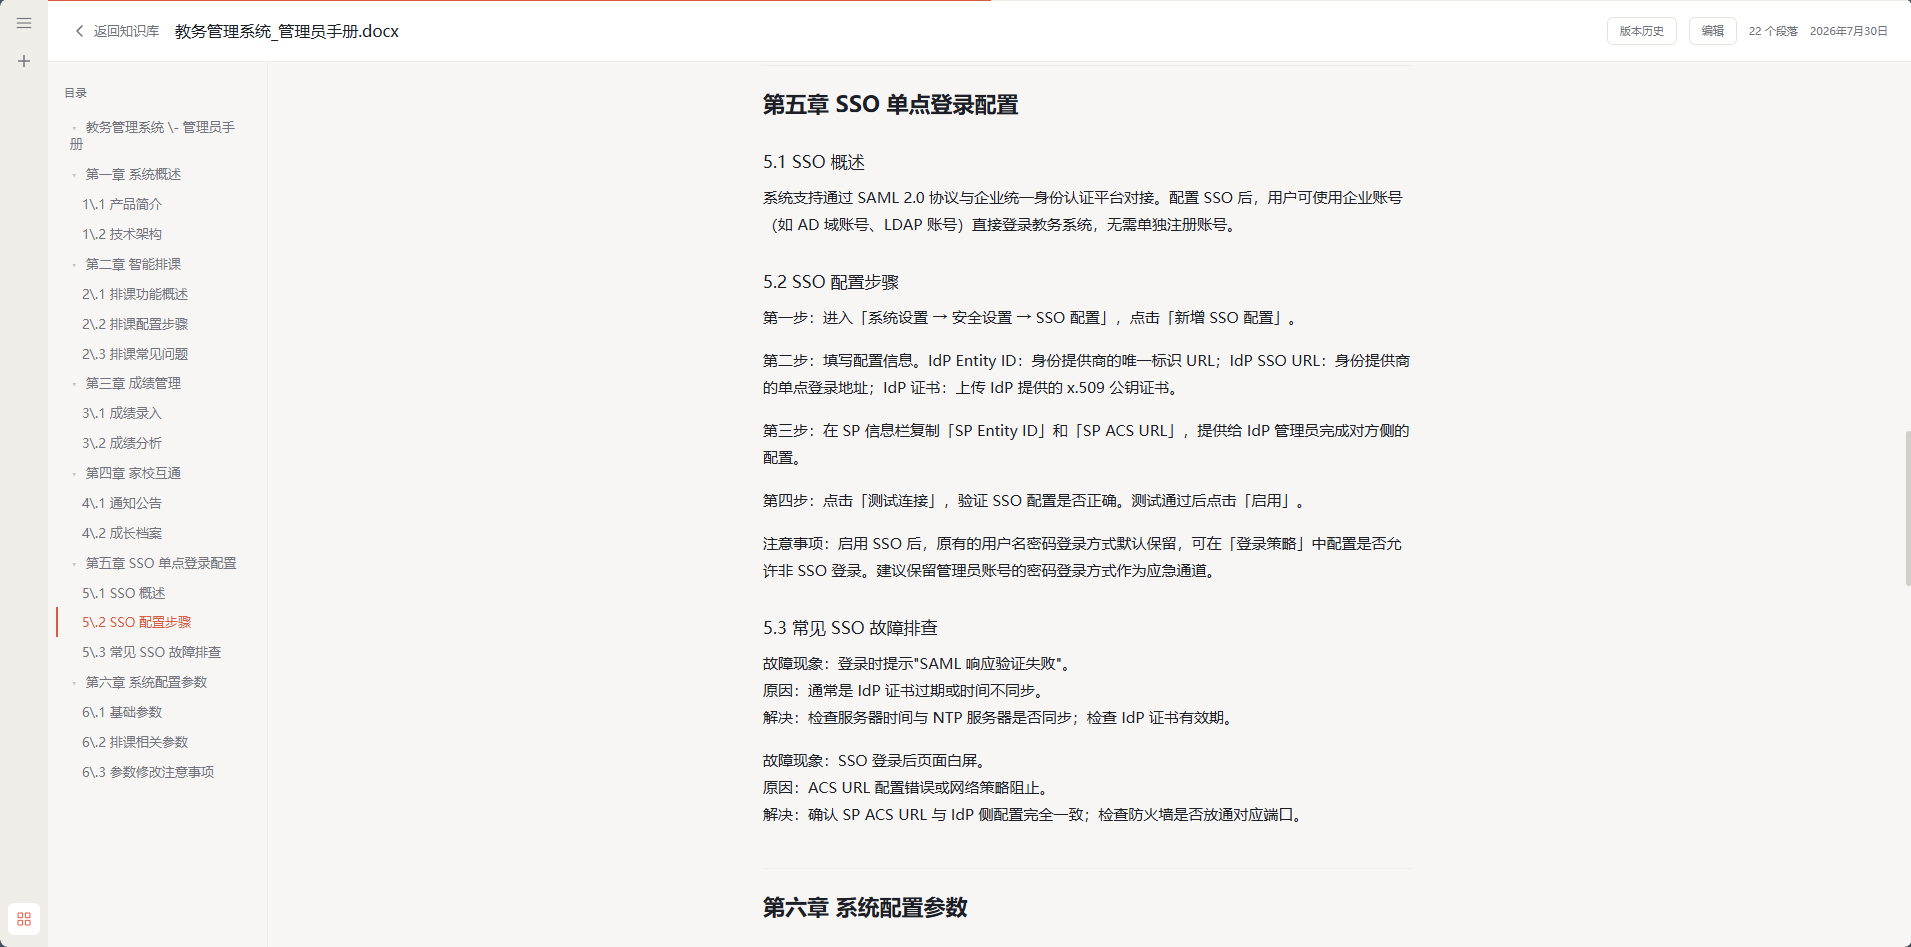
上传 DOCX / PDF / Markdown,系统自动解析、按段落切片、调用本地 BGE 模型生成 embedding、写入 ChromaDB。表格、列表、标题层级一并保留,引用时能精确到段。
自然语言问答 + 流式输出§
DeepSeek 基于检索到的 top-k 段落生成回答,SSE 流式推到前端,首字 < 5 秒。Markdown 渲染 + 内联引用标记 [N],点 [N] 在右侧滑出原文片段和出处(文档名 / 章节 / 页码)。
引用溯源§
每条回答强制要求模型标注引用来源,回答末尾附完整引用列表。只允许基于原文回答——这是通过 prompt 约束 + 检索阈值(相似度 < 0.5 直接拒答)双重保证的。
诚实兜底§
知识库里没有相关内容时,明确回复"未找到相关信息",绝不编造。这是产品层最关键的差异化,也是用户最在意的可信度——宁可承认不知道,也不能给错答案。
引用溯源 + 诚实机制(双差异化)§
引用溯源:每条回答强制要求模型标注引用来源,回答末尾附完整引用列表(文档名 / 章节 / 页码)。只允许基于原文回答——通过 prompt 约束 + 检索阈值(相似度 < 0.5 直接拒答)双重保证。
诚实机制:知识库里没有相关内容时,明确回复"未找到相关信息",绝不编造。两个机制一起把"AI 答得对"翻译成产品语言——这是和市面上"自信胡说"的 AI 工具的核心区别。
反馈闭环:让 AI 产品可演进§
用户反馈 → 👍/👎 + 文字评论
        → BadCase 分类(irrelevant / wrong / incomplete / hallucination / not_found / too_slow)
        → Prompt 补丁自动注入(按分类匹配规则,patch 进 system prompt)
        → 下版本发布,无需人工改 prompt
每条回答下方有 👍 / 👎 按钮,👎 可补充文字反馈。每周抽 10 条对话人工复盘,反哺检索阈值和 prompt 优化。这是 AI 产品区别于一次性项目的关键能力——能基于真实用户行为持续进化。
文件夹监控(运维友好)§
指定一个本地目录,后台 watch 服务自动监听新文件,触发摄入流程。新增文档无需手动上传——只要放到指定目录就能进入知识库。
技术架构§
┌─────────────┐    SSE     ┌─────────────┐
│  Next.js 14 │ ─────────► │   FastAPI   │
│  (chat UI)  │ ◄───────── │  (RAG 管道) │
└─────────────┘   stream   └──────┬──────┘
                                  │
                ┌─────────────────┼─────────────────┐
                ▼                 ▼                 ▼
          ┌──────────┐      ┌──────────┐      ┌──────────┐
          │ ChromaDB │      │  SQLite  │      │ DeepSeek │
          │ (向量库) │      │ (对话/反馈)│     │   API    │
          └──────────┘      └──────────┘      └──────────┘
                ▲
                │ embedding
          ┌─────┴────┐
          │   BGE    │ (本地 fastembed + ONNX)
          └──────────┘
关键选型理由:
- 自建 RAG 管道,不用 LlamaIndex —— 切片、检索、重排、引用拼接都需要按教育文档特点定制,框架反而碍事
- BGE 本地 embedding —— 中文语义召回强,无 API 费用、无数据外传风险,首启慢一点(模型下载 + 预热)但稳
- ChromaDB 嵌入式模式 —— 单机部署零运维,SQLite 同样思路,整个后端可以打包成一个 Docker 镜像
- DeepSeek —— 中文场景性价比最高,function calling / 长上下文都够用
Spike 验证结果§
半天时间用最小依赖脚本验证"DeepSeek + ChromaDB 能基于公司产品文档给出准确、可引用的中文回答"。
| 检查项 | 标准 | 结果 |
|---|---|---|
| 检索命中率 | Top-4 中包含正确答案 ≥ 80% | ✅ 通过(5/5 测试问题) |
| 回答准确性 | 基于文档,不编造 | ✅ 通过(人工对照原文) |
| 引用可追溯 | 每个 [N] 能对应到具体段落 |
✅ 通过 |
| 首字延迟 | < 5 秒 | ✅ 通过(~3s) |
数据 / 效果§
| 指标 | 数值 |
|---|---|
| 语义化版本 | 4 个(0.1.0 → 0.4.0) |
| 文档完整度 | 覆盖 10 份工程文档 |
| 检索 top-k | 4 |
| Embedding 维度 | 512(BGE-small-zh-v1.5) |
| LLM | deepseek-chat(流式) |
| 首字延迟 | < 3 秒 |
| 摄入速度 | ~30 秒 / 份文档(含切片 + 向量化) |
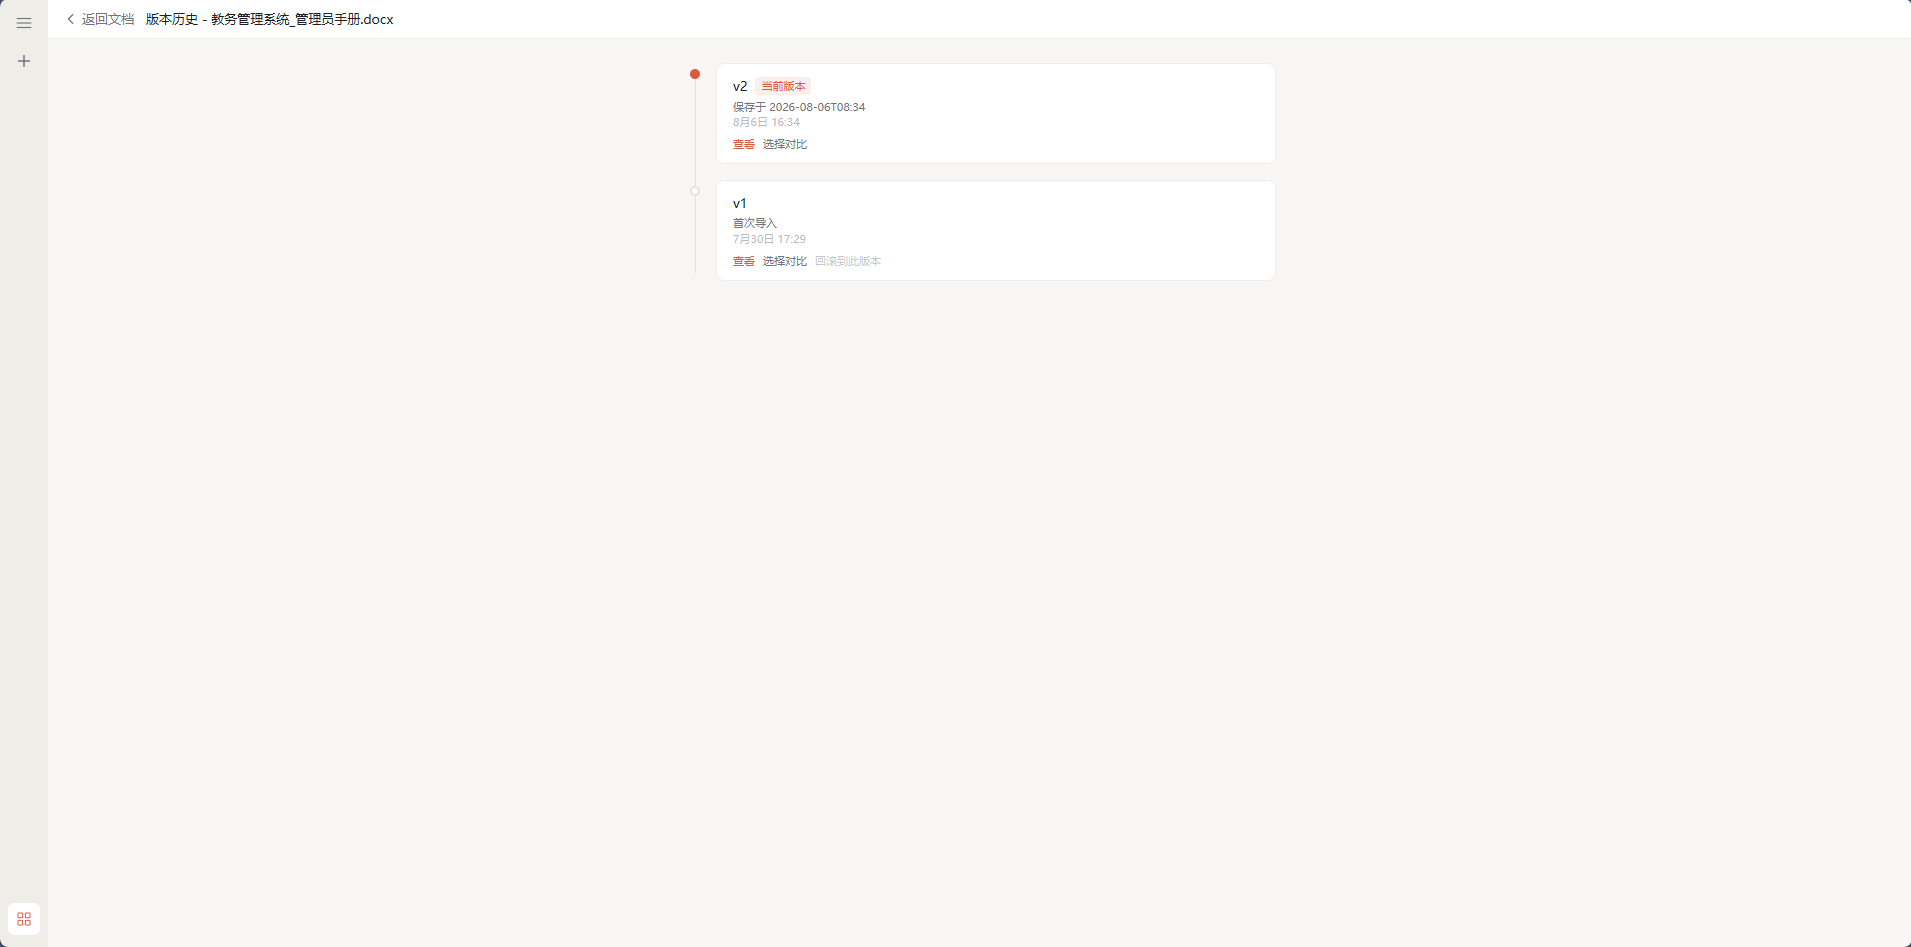
| 反馈闭环 | 👍/👎 + 6 类 BadCase 标签 + Prompt 补丁自动注入 |